
Я занимаюсь разработкой ИИ воркфлоу, интегрирую ИИ в телеграмм, делаю различных ассистентов и вообще автоматизирую различные процессы в бизнесе. Берусь за проекты различной сложности и всегда открыт к сотрудничеству, телеграмм - https://t.me/haknnde портфолио - https://t.me/AIBuisnessTools
Всем привет дорогие друзья, я раньше спрашивал стоит ли делать тему про липсинк генератор, так вот теперь я ее делаю)
Важное уточнение: информации про это нет в открытом доступе(почему то) ни в РУ, ни в зарубежном сегменте, мне пришлось с этой всей фигней разбираться самому и это было просто ужасно, буду рад если прочитаете до конца и дадите конструктивную критику.
О софте: Infinite Talk это опен соус ИИ генератор липсинков, он работает как i2v (фото в видео) так и v2v (видео в видео). Он требует серьезных мощностей, лично я тестировал на сервере с видеокартой Nvidia H200 и качеством 480р и 720р (выше качества модели просто не поддерживают). Сам по себе софт работает на ComfyUI, сервер я использовал от Vast AI потому что дешево и очень мощно(НЕ реклама). Ниже приведу примеры своих генераций. И еще, конкретно в этой статье я разбираю v2v генерацию (видео в видео), так что если вам будет интересно генерация и i2v (фото в видео) пишите в комментах, я сделаю.
1. Оригинал видео(нет звука):
Открыть видео / медиа
То что сгенерировал:
Открыть видео / медиа
2. Слева оригинал, справа синк:
Открыть видео / медиа
Открыть видео / медиа
То что сгенерировал:
Открыть видео / медиа
2. Слева оригинал, справа синк:
Открыть видео / медиа
1. Подготовка окружения
Для начала, заходим на Vast AI [реф| не реф]и регаемся, для начала нужно выбрать темплейт для запуска, лично я создал свой (ссылка на темплейт) и я рекомендую использовать его, потому что там стоят все нужные зависимости и правильные версии, иначе у вас может не работать нормально воркфлоу с моделями. После выбора темплейта, ставим объем памяти инстанса (рекомендую около 130-150гб) и выбираем сервер для аренды. P.S.: если вы хотите использовать какой либо другой темплейт, то для запуска этой модели нужен темплейт с ComfyUI.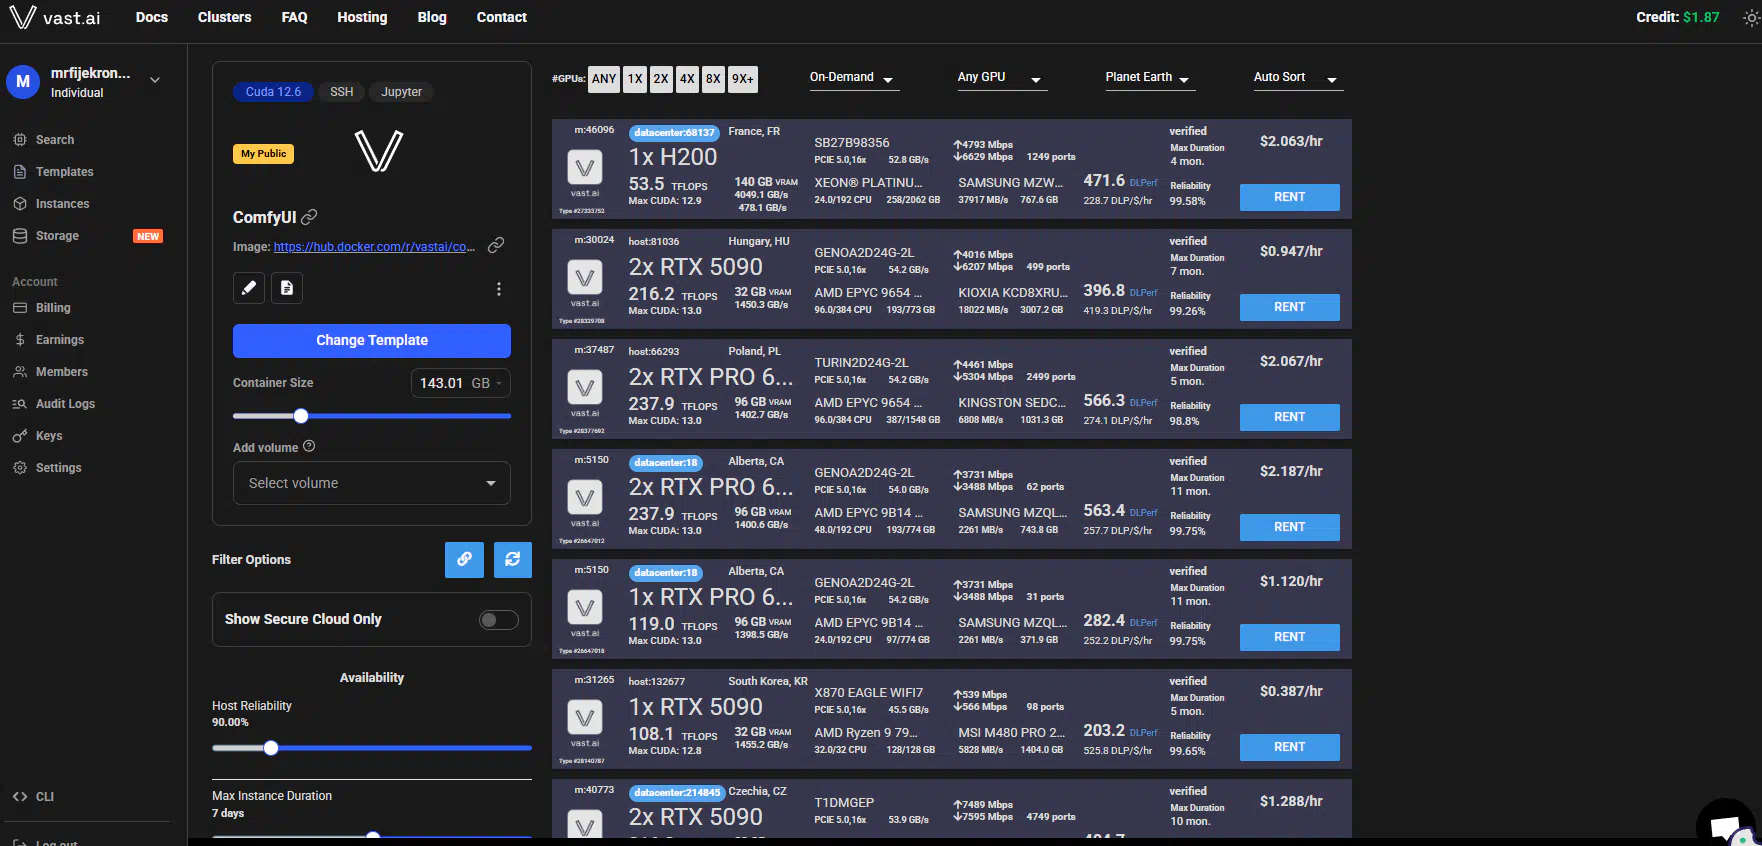
2. Запуск и установка моделей для работы workflow
После того как мы выбрали сервер и запустили инстанс, ждемс около минуты (если первый запуск, темплейт может кешироваться и это займет чуть дольше) и заходим в Dashboard. В нем мы увидим несколько опций, конкретно нас, сначала интересует опция Jupiter Terminal. Нам надо зайти в терминал и установить нужные модели. Вы по умолчанию окажетесь в директории workspace, поэтому просто делаем следующие шаги:
Переходим в папку ComfyUI/models/diffusion_models/ и устанавливаем сюда следующие модели при помощи команды wget:
-
(нужно перейти по ссылкам, и на сайте нажать "Copy download link" и именно эту ссылку нужно вставлять с командой wget в терминале) - После того как мы установили эти модели, заходим в папку ComfyUI/models/vae и скачиваем vae декодер\энкодер
- После установки vae, заходим в папку ComfyUI/models/text_encoders и скачиваем сюда модели распознавания текста
- После установки текст энкодера, заходим ComfyUI/models/clip_vision и скачиваем следующий файл
- Заходим в папку ComfyUI/models/loras и скачиваем апскейлер
После установки всех выше перечисленных файлов, нам остается лишь найти видео которые мы хотим прогнать через воркфлоу и звук который надо наложить.
3. Запуск синка
Теперь нужно взять воркфлоу который будет все это генерировать и просто его запустить, ниже я прикреплю файл который я сам использовал для генерации, что бы его открыть нужно просто запустить ComfyUI в Dashboard и перетащить туда этот файл.
После того как мы все установили и загрузили воркфлоу, он будет выглядеть примерно так:
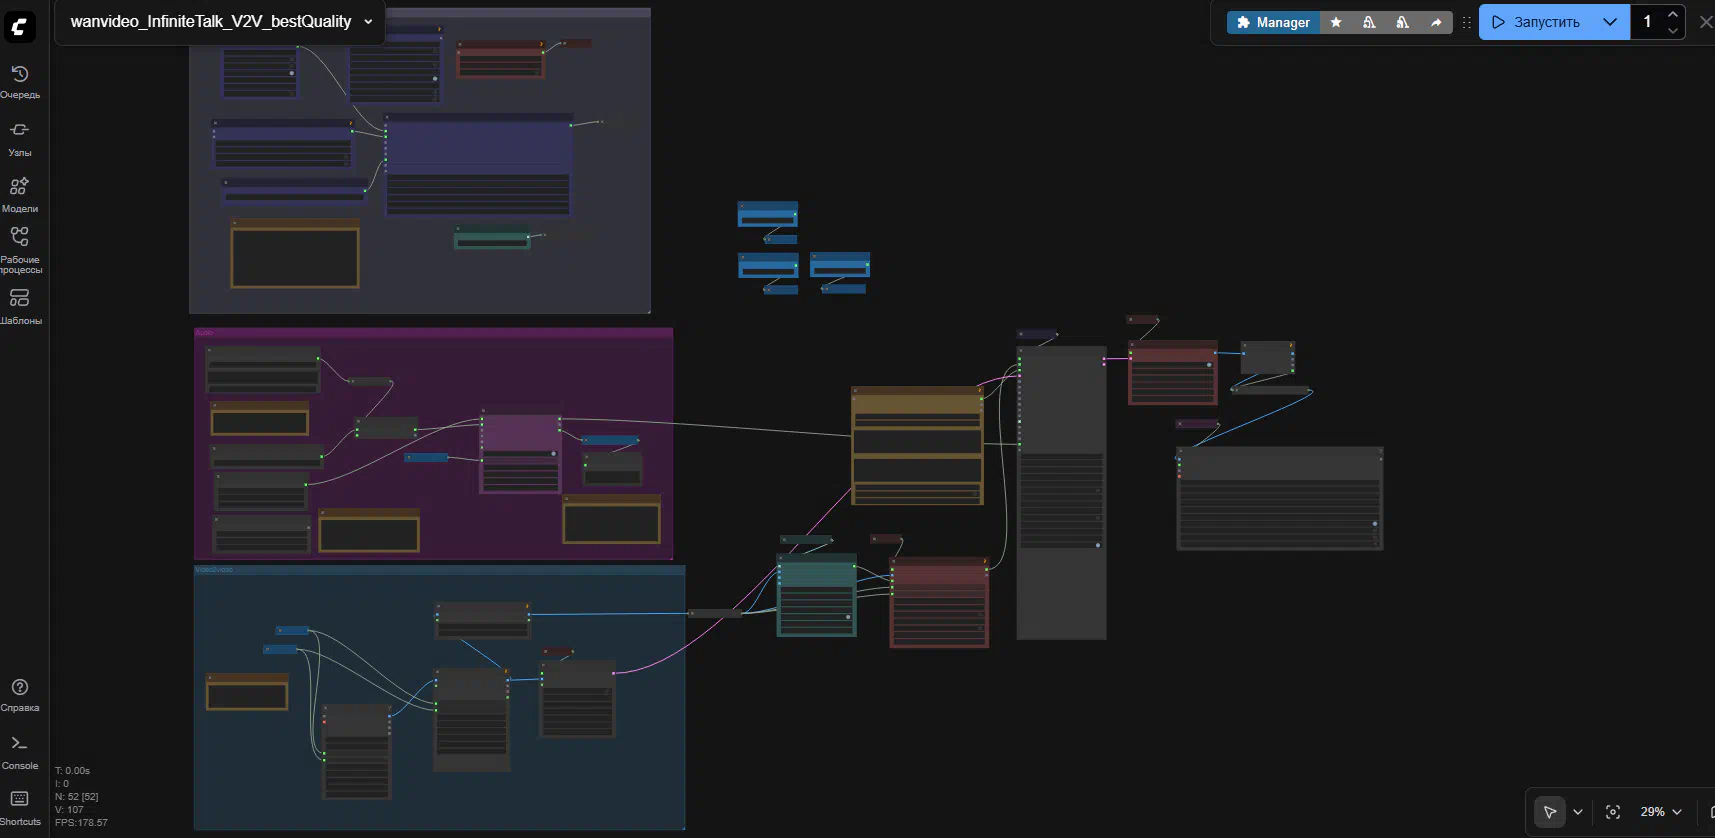
1. Загружаем видос ТУТ
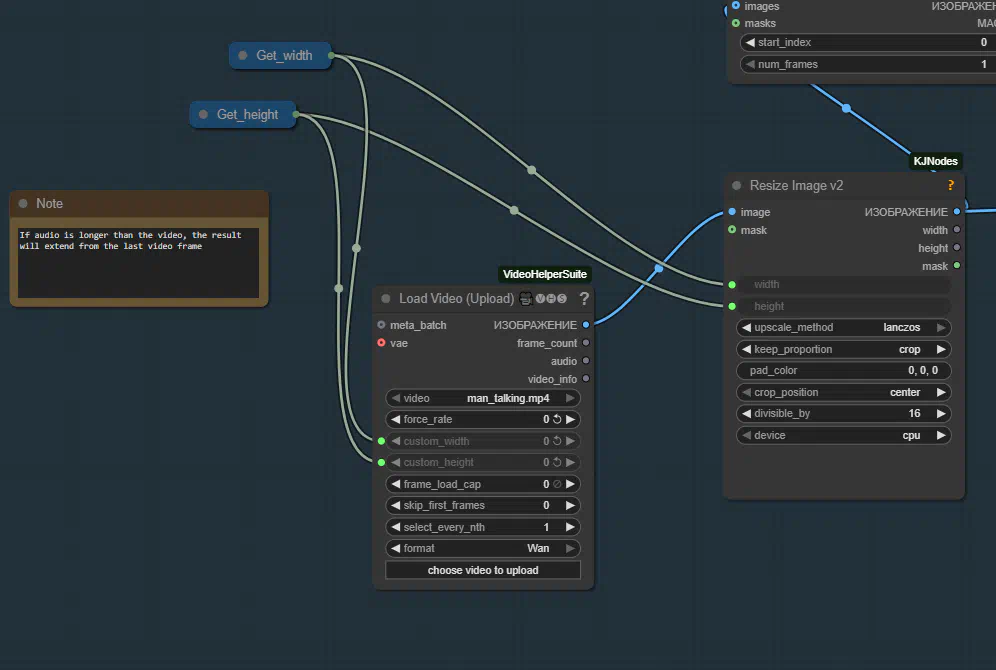
(кнопочка choose video to upload)
2. Загружаем аудио
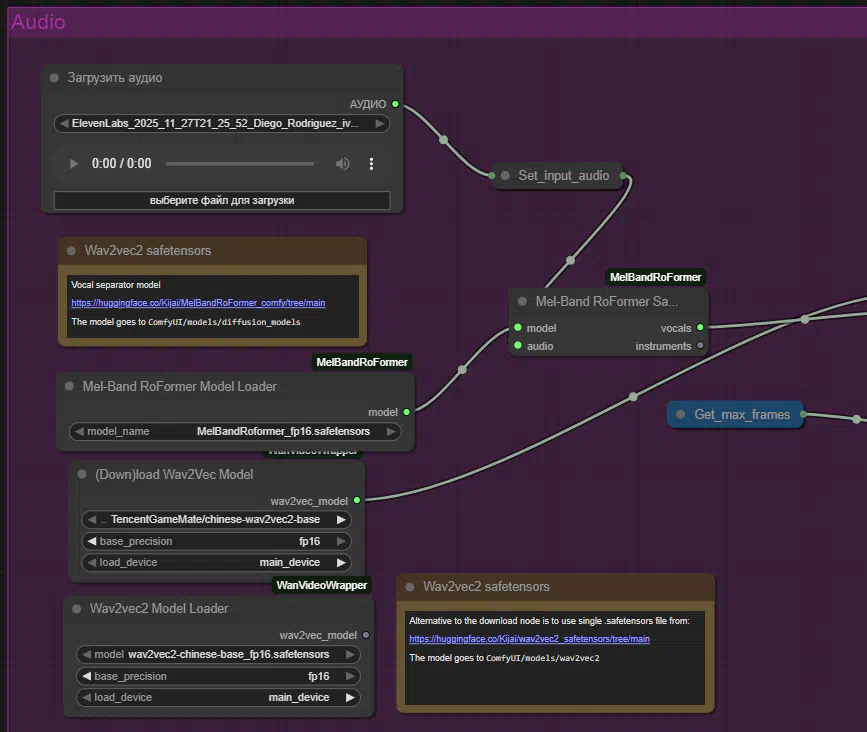
3. Пишем промпт
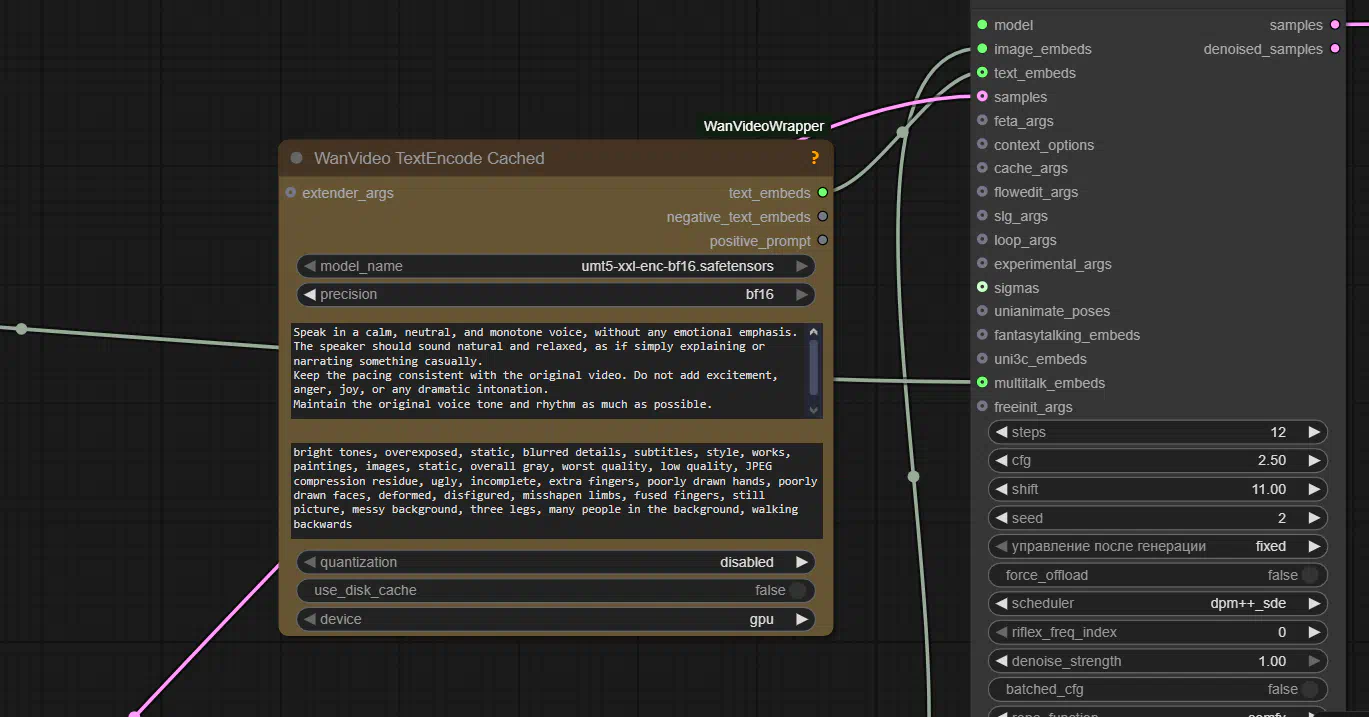
(Верхняя строка это positive prompt, нижняя строка это negative prompt, можете менять их на свое усмотрение)
(кнопочка choose video to upload)
2. Загружаем аудио
3. Пишем промпт
(Верхняя строка это positive prompt, нижняя строка это negative prompt, можете менять их на свое усмотрение)
P.S: Забыл добавить, установите ноды которые будет требовать воркфлоу. Это делается в правом верхнем углу, там нажимаете на менеджер, и в нем будет "Установить ноды". В принципе проблем не должно возникнуть, единственное что, если у вас установлена нода, но показывает что ее нет (вылазит ошибка) в этом же менеджере нод, просто зайдите во вкладку Install missing nodes и в ней удалите, перезапустить воркфлоу, и снова с качайте. Будет работать. Если что кидайте ошибки в комменты, я помогу пофиксить
Какие проблемы могут возникнуть: может быть такое что вы запустите, и вам выдаст ошибку что у вас не установлены нужные модели. Не бойтесь! В таком случае ноды в которых выбраны модели просто не видят их. Для того что бы пофиксить эту тему, нода в которой не выбрана модель будет окружена красной линией, просто нажмите на название модели в ней и выберете ту же самую модель которая написана в поле Model ноды.
Настройки: в этом воркфлоу можно менять скорость и качество рендера, на это влияет: Количество шагов(чем выше тем лучше качество, но медленнее рендер) и cfg (четкость губ, идеально в диапазоне 2-2.5 иначе может быть слишком зажато) в ноде WanVideo Sampler, либо в нодах wanVideo decode/encode есть параметры tile_x\y и tile_stride_x\y, вот они тоже чем выше тем дольше рендер но выше качество, tile_stride_x\y должен быть в 2 раза меньше чем tile_x\y. Дальше можете поиграться, покликать на разные параметры, возможно добьетесь хорошего качества для себя. Еще, важно что бы фпс исходника был такой же как и фпс финального видоса, так что смотрите на фпс в ноде video combine. И финальное, ставьте разрешение в рамках адекватного, в 4к модель вам не сможет зарендерить, лучше максимум 1280х720.
Всем спасибо за внимание!
Было потрачено много времени для того что бы получить всю эту информацию, если вам понравиться статья, я сделаю второй пост про i2v генерацию, всем удачи и много денег
Было потрачено много времени для того что бы получить всю эту информацию, если вам понравиться статья, я сделаю второй пост про i2v генерацию, всем удачи и много денег
UPD: У меня отьебнуло инстанс на васте, теперь мне самому понадобилась моя же статья, лол. Не будьте дураками друзья, не храните данные локально и делайте бекапы :love2:
Комментарии 0